LLaMA-Factory 微调实践手册
整理 LLaMA-Factory 的安装、训练命令、数据格式、评估、部署和故障排查。
GitHub链接: https://github.com/hiyouga/LLaMA-Factory
一、安装
git clone https://github.com/hiyouga/LLaMA-Factory.git
conda create -n llama_factory python=3.10
conda activate llama_factory
cd LLaMA-Factory
pip install -e .[metrics] #方式一
pip install -e ".[torch,metrics]" #方式二
#若遇到包冲突,可用pip install --no-deps -e .
pip install -e .[依赖项]
可选的额外依赖项:torch、torch-npu、metrics、deepspeed、liger-kernel、bitsandbytes、hqq、eetq、gptq、aqlm、vllm、sglang、galore、apollo、badam、adam-mini、qwen、minicpm_v、modelscope、openmind、swanlab、quality二、校验
llamafactory-cli train -h三、指令
llamafactory-cli
| 动作参数枚举 | 参数说明 |
|---|---|
| version | 显示版本信息 |
| train | 命令行版本训练 |
| chat | 命令行版本推理chat |
| export | 模型合并和导出 |
| api | 启动API server,供接口调用 |
| eval | 使用mmlu等标准数据集做评测 |
| webchat | 前端版本纯推理的chat页面 |
| webui | 启动LlamaBoard前端页面,包含可视化训练,预测,chat,模型合并多个子页面< |
| model_name_or_path | 参数的名称(huggingface或者modelscope上的标准定义,如“meta-llama/Meta-Llama-3-8B-Instruct”), 或者是本地下载的绝对路径,如/media/codingma/LLM/llama3/Meta-Llama-3-8B-Instruct |
| template | 模型问答时所使用的prompt模板,不同模型不同,请参考https://github.com/hiyouga/LLaMA-Factory?tab=readme-ov-file#supported-models 获取不同模型的模板定义,否则会回答结果会很奇怪或导致重复生成等现象的出现。chat 版本的模型基本都需要指定,比如Meta-Llama-3-8B-Instruct的template 就是 llama3 |
其中参数model_name_or_path也可以提前把相关的参数存在yaml文件里,比如LLaMA-Factory/examples/inference/llama3.yaml at main · hiyouga/LLaMA-Factory, 本地位置是 examples/inference/llama3.yaml ,内容如下
model_name_or_path: /media/codingma/LLM/llama3/Meta-Llama-3-8B-Instruct
template: llama3
训练指令
llamafactory-cli train 路径转换为GGUF格式
安装llama.cpp并执行转换:
python llama.cpp/convert_hf_to_gguf.py 输入模型路径 --outfile 输出路径.gguf --outtype q8_0脚本
基础训练配置
#!/bin/bash

CUDA_VISIBLE_DEVICES=0 llamafactory-cli train \
    --stage sft \
    --do_train \
    --do_eval \
    --model_name_or_path ./models/llama3-8b-instruct \
    --dataset my_dataset,alpaca_zh \
    --dataset_dir ./train_data \
    --template llama3 \
    --finetuning_type lora \
    --lora_target all \
    --output_dir ./saves/llama3-8b-lora \
    --overwrite_cache \
    --overwrite_output_dir \
    --cutoff_len 2048 \
    --preprocessing_num_workers 8 \
    --per_device_train_batch_size 2 \
    --per_device_eval_batch_size 1 \
    --gradient_accumulation_steps 8 \
    --lr_scheduler_type cosine \
    --logging_steps 50 \
    --save_steps 200 \
    --eval_steps 100 \
    --eval_strategy steps \
    --load_best_model_at_end \
    --learning_rate 1e-4 \
    --num_train_epochs 3.0 \
    --max_samples 5000 \
    --val_size 0.1 \
    --plot_loss \
    --fp16
高级训练配置(全参数微调)
#!/bin/bash

CUDA_VISIBLE_DEVICES=0,1,2,3 llamafactory-cli train \
    --stage sft \
    --do_train \
    --model_name_or_path ./models/llama3-8b-instruct \
    --dataset my_dataset \
    --dataset_dir ./train_data \
    --template llama3 \
    --finetuning_type full \
    --output_dir ./saves/llama3-8b-full \
    --overwrite_cache \
    --overwrite_output_dir \
    --cutoff_len 2048 \
    --preprocessing_num_workers 16 \
    --per_device_train_batch_size 1 \
    --gradient_accumulation_steps 16 \
    --lr_scheduler_type cosine \
    --logging_steps 10 \
    --save_steps 500 \
    --learning_rate 5e-6 \
    --num_train_epochs 2.0 \
    --max_grad_norm 1.0 \
    --warmup_ratio 0.1 \
    --lr_scheduler_type cosine \
    --bf16 \
    --deepspeed deepspeed_config.json
训练监控
#!/bin/bash

CUDA_VISIBLE_DEVICES=0,1,2,3 llamafactory-cli train \
    --stage sft \
    --do_train \
    --model_name_or_path ./models/llama3-8b-instruct \
    --dataset my_dataset \
    --dataset_dir ./train_data \
    --template llama3 \
    --finetuning_type full \
    --output_dir ./saves/llama3-8b-full \
    --overwrite_cache \
    --overwrite_output_dir \
    --cutoff_len 2048 \
    --preprocessing_num_workers 16 \
    --per_device_train_batch_size 1 \
    --gradient_accumulation_steps 16 \
    --lr_scheduler_type cosine \
    --logging_steps 10 \
    --save_steps 500 \
    --learning_rate 5e-6 \
    --num_train_epochs 2.0 \
    --max_grad_norm 1.0 \
    --warmup_ratio 0.1 \
    --lr_scheduler_type cosine \
    --bf16 \
    --deepspeed deepspeed_config.json
模型评估
自动评估
#!/bin/bash

echo "=== 开始模型评估 ==="

llamafactory-cli eval \
    --model_name_or_path ./models/llama3-8b-instruct \
    --adapter_name_or_path ./saves/llama3-8b-lora \
    --template llama3 \
    --finetuning_type lora \
    --task chat \
    --eval_dataset alpaca_zh \
    --dataset_dir ./train_data \
    --per_device_eval_batch_size 2 \
    --predict_with_generate \
    --max_samples 200 \
    --save_name quantitative_eval

llamafactory-cli train \
    --stage sft \
    --do_predict \
    --model_name_or_path ./models/llama3-8b-instruct \
    --adapter_name_or_path ./saves/llama3-8b-lora \
    --eval_dataset my_dataset \
    --dataset_dir ./train_data \
    --template llama3 \
    --finetuning_type lora \
    --output_dir ./saves/llama3-8b-lora/predict \
    --per_device_eval_batch_size 1 \
    --max_samples 20 \
    --predict_with_generate

echo "=== 评估完成 ==="
评估结果分析
import json
import matplotlib.pyplot as plt

def analyze_evaluation_results():
    """分析评估结果"""

    # 读取评估指标
    try:
        with open('./saves/llama3-8b-lora/quantitative_eval/eval_results.json', 'r') as f:
            results = json.load(f)

        print("=== 评估结果分析 ===")
        metrics = {
            "BLEU-4": results.get("predict_bleu-4", "N/A"),
            "ROUGE-1": results.get("predict_rouge-1", "N/A"),
            "ROUGE-2": results.get("predict_rouge-2", "N/A"),
            "ROUGE-L": results.get("predict_rouge-l", "N/A")
        }

        for metric, value in metrics.items():
            print(f"{metric}: {value}")

        # 可视化指标
        if all(isinstance(v, (int, float)) for v in metrics.values()):
            plt.figure(figsize=(10, 6))
            plt.bar(metrics.keys(), metrics.values())
            plt.title("模型评估指标")
            plt.ylabel("分数")
            plt.xticks(rotation=45)
            plt.tight_layout()
            plt.savefig('./saves/llama3-8b-lora/evaluation_metrics.png')
            print("指标图表已保存")

    except FileNotFoundError:
        print("评估结果文件不存在")

if __name__ == "__main__":
    analyze_evaluation_results()
模型部署和使用
Web UI部署
llamafactory-cli webui \
    --model_name_or_path ./models/llama3-8b-instruct \
    --adapter_name_or_path ./saves/llama3-8b-lora \
    --template llama3 \
    --finetuning_type lora
API服务部署
llamafactory-cli api \
    --model_name_or_path ./models/llama3-8b-instruct \
    --adapter_name_or_path ./saves/llama3-8b-lora \
    --template llama3 \
    --finetuning_type lora \
    --port 8000
命令行测试
llamafactory-cli chat \
    --model_name_or_path ./models/llama3-8b-instruct \
    --adapter_name_or_path ./saves/llama3-8b-lora \
    --template llama3 \
    --finetuning_type lora
完整流程执行脚本
#!/bin/bash

set -e  # 遇到错误立即退出

echo "=== LLaMA-Factory 完整微调流程 ==="

echo "步骤1: 数据准备"
python data_prepare.py

echo "步骤2: 开始训练"
chmod +x basic_train.sh
./basic_train.sh &

echo "步骤3: 启动训练监控"
gnome-terminal -- python training_monitor.py

wait

echo "步骤4: 模型评估"
chmod +x evaluation.sh
./evaluation.sh

echo "步骤5: 结果分析"
python analyze_results.py

echo "步骤6: 部署模型"
echo "启动Web UI: llamafactory-cli webui --model_name_or_path ./models/llama3-8b-instruct --adapter_name_or_path ./saves/llama3-8b-lora"

echo "=== 流程完成 ==="
四、数据集
目前仅支持两种格式的数据集:alpaca 和 sharegpt。
alpaca
[
  {
    "instruction": "用户指令(必填)",
    "input": "用户输入(选填)",
    "output": "模型回答(必填)",
    "system": "系统提示词(选填)",
    "history": [
      ["第一轮指令(选填)", "第一轮回答(选填)"],
      ["第二轮指令(选填)", "第二轮回答(选填)"]
    ]
  }
]在LLaMA-Factory项目中均使用dataset_info.json进行定义和管理,其存储位置在LLaMA-Factory/data目录下。
文件格式如下:
"数据集名称": {
  "hf_hub_url": "Hugging Face 的数据集仓库地址(若指定,则忽略 script_url 和 file_name)",
  "ms_hub_url": "ModelScope 的数据集仓库地址(若指定,则忽略 script_url 和 file_name)",
  "script_url": "包含数据加载脚本的本地文件夹名称(若指定,则忽略 file_name)",
  "file_name": "该目录下数据集文件的名称(若上述参数未指定,则此项必需)",
  "file_sha1": "数据集文件的 SHA-1 哈希值(可选,留空不影响训练)",
  "subset": "数据集子集的名称(可选,默认:None)",
  "folder": "Hugging Face 仓库的文件夹名称(可选,默认:None)",
  "ranking": "是否为偏好数据集(可选,默认:False)",
  "formatting": "数据集格式(可选,默认:alpaca,可以为 alpaca 或 sharegpt)",
  "columns(可选)": {
    "prompt": "数据集代表提示词的表头名称(默认:instruction)",
    "query": "数据集代表请求的表头名称(默认:input)",
    "response": "数据集代表回答的表头名称(默认:output)",
    "history": "数据集代表历史对话的表头名称(默认:None)",
    "messages": "数据集代表消息列表的表头名称(默认:conversations)",
    "system": "数据集代表系统提示的表头名称(默认:None)",
    "tools": "数据集代表工具描述的表头名称(默认:None)"
  },
  "tags(可选,用于 sharegpt 格式)": {
    "role_tag": "消息中代表发送者身份的键名(默认:from)",
    "content_tag": "消息中代表文本内容的键名(默认:value)",
    "user_tag": "消息中代表用户的 role_tag(默认:human)",
    "assistant_tag": "消息中代表助手的 role_tag(默认:gpt)",
    "observation_tag": "消息中代表工具返回结果的 role_tag(默认:observation)",
    "function_tag": "消息中代表工具调用的 role_tag(默认:function_call)",
    "system_tag": "消息中代表系统提示的 role_tag(默认:system,会覆盖 system 列)"
  }
}
所以对于alpaca格式的数据,dataset_info.json 中的 columns 应为:
"数据集名称": {
  "columns": {
    "prompt": "instruction",
    "query": "input",
    "response": "output",
    "system": "system",
    "history": "history"
  }
}
sharegpt
其标准形式如下:
[
  {
    "conversations": [
      {
        "from": "human",
        "value": "用户指令"
      },
      {
        "from": "gpt",
        "value": "模型回答"
      }
    ],
    "system": "系统提示词(选填)",
    "tools": "工具描述(选填)"
  }
]
关于sharegpt 格式,在dataset_info.json中的定义形式就是如下:
"数据集名称": {
  "columns": {
    "messages": "conversations",
    "system": "system",
    "tools": "tools"
  },
  "tags": {
    "role_tag": "from",
    "content_tag": "value",
    "user_tag": "human",
    "assistant_tag": "gpt"
  }
}
五、WebUI
模块一:模型与方法
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 语言 | zh |
将界面切换为中文,方便操作。 |
| 模型名称 | Qwen/Qwen2.5-VL-3B-Instruct |
LLaMA-Factory 会自动从 HuggingFace 或 ModelScope 下载。 |
| 模型路径 | 默认 | 若已有本地模型,可填写绝对路径。 |
| 微调方法 | LoRA |
低秩适应微调,在效果和资源消耗之间取得了最佳平衡,是目前的主流选择。 |
| 量化等级 | none (不量化) |
4-bit 量化可大幅节省显存,但对模型精度有轻微影响。初次训练建议不量化。 |
| 对话模板 | qwen2_vl |
至关重要。必须与模型(Qwen2.5-VL)严格匹配,否则模型无法正确理解输入。 |
模块二:训练设置
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 训练阶段 | Supervised Fine-Tuning |
监督微调,适用于我们准备的“问答”式标注数据。 |
| 数据目录 | ./pokemon_sharegpt |
指向您准备好的数据集文件夹。 |
| 数据集 | pokemon_multimodal |
选中我们刚才在 dataset_info.json 中定义的数据集名称。 |
| 截断长度 | 4096 |
模型能处理的最大序列长度。对于图文模型,建议不低于 2048 以确保图像编码有足够空间。 |
| 学习率 | 2e-4 |
这是 LoRA 微调 3B 级别模型的黄金学习率。如果 Loss 不下降可升至 3e-4,若震荡则降至 1e-4。 |
| 训练轮数 | 3 |
对于中小规模数据集(< 10k 条),3-5 轮通常足够。过多轮次可能导致过拟合。 |
| 批处理大小 | 2 |
每张 GPU 一次处理的样本数。受显存限制,24GB 显存可尝试 2-4,16GB 建议 1-2。 |
| 梯度累积 | 8 |
“模拟”大批量训练的技巧。有效批量 = 批处理大小 × 梯度累积。这里有效批量为 16,是公认的稳定值。 |
| 计算类型 | bf16 |
强烈推荐。适用于新架构显卡(A100, RTX 30/40系),数值稳定性优于 fp16。 |
| 学习率调节器 | cosine |
余弦退火调度器,能使学习率平滑下降,有助于模型收敛到更优的点。 |
| 验证集比例 | 0.1 |
从训练集中划分 10% 的数据用于验证,以监控模型是否过拟合。 |
| 输出目录 | saves/qwen25-vl-pokemon-lora |
保存 LoRA 权重、日志和训练图表的文件夹。 |
| 日志间隔 | 10 |
每训练 10 步在控制台和日志文件中输出一次 Loss 等信息。 |
| 保存间隔 | 500 |
每训练 500 步保存一次模型权重(checkpoint)。 |
| LoRA 秩 | 64 |
LoRA 矩阵的维度。越大,可训练参数越多,拟合能力越强,但显存占用也越高。64 是一个很好的平衡点。 |
| LoRA 缩放系数 | 128 |
通常设为 rank 的 2倍,这是一个广泛验证过的有效配置。 |
| LoRA 随机丢弃 | 0.1 |
在 LoRA 模块中加入 Dropout,能有效防止过拟合,增强模型泛化能力。 |
| LoRA 作用模块 | all |
将 LoRA 应用于模型的所有线性层。对于初学者来说,这是最简单且效果不错的选择。 |
训练过程监控与故障排除
监控显存
pip install nvitop
pip install nvdida-ml-py -u
nvitop -m auto
nvitop -m compact
nvitop -m full
监控关键指标
- Loss:最重要的指标。你应该观察到
loss值随着训练进行而持续下降,并在训练后期趋于平稳。 - Learning Rate:会根据选择的
cosine调度器从初始值2e-4平滑下降。 - Loss 曲线图:训练完成后,在输出目录(
saves/qwen25-vl-pokemon-lora)下会生成training_loss.png。一条健康的曲线应平滑下降并收敛。
常见问题与解决方案
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
| CUDA out of memory | 批量大小过大或截断长度过长。 | 1. 降低批处理大小 至 1。 2. 如仍溢出,降低 LoRA 秩 至 32。 3. 最终手段:降低截断长度。 |
| Loss 不下降或上升 | 学习率过低或数据有问题。 | 1. 提高学习率 至 3e-4。 2. 仔细检查数据集格式和内容。 |
| Loss 剧烈震荡 | 学习率过高。 | 降低学习率 至 1e-4。 |
| 训练速度过慢 | 硬件限制或配置问题。 | 1. 确认已安装 flash-attn。 2. 适当减少梯度累积步数。 |
模型评估与测试
训练完成后,切换到 Evaluate 标签页。
- 选择适配器:在 检查点路径 下拉框中,选择刚刚训练好的模型(位于
saves/...目录下)。 - 配置评估:选择
pokemon_multimodoal数据集,设置一个小的最大样本数(如100)进行快速评估。
对话测试
- 切换到 Chat 标签页。
- 加载适配器:同样,在 适配器路径 中选中你的模型。
- 加载模型:点击 *加载模型 按钮,等待模型加载完成。
- 开始对话:
对比测试:要感受微调带来的提升,可以点击 卸载模型,然后不选择任何适配器,再次点击 加载模型 加载原始的 Qwen2.5-VL-3B-Instruct 模型,用同样的问题进行测试,对比效果差异。
进阶调优技巧
- 混合数据集:在 WebUI 中可以同时选择多个数据集进行训练,这能提升模型的泛化能力。
- 使用 LoRA+:在“高级设置”中勾选 使用 LoRA+ 并设置 LoRA+ 学习率比例 为
16.0。LoRA+ 是一种改进算法,理论上能以相同的成本提升模型性能,值得尝试。 - 调整 LoRA 目标:如果发现模型在图像理解上出现问题,可以尝试仅微调语言部分。在 LoRA 作用模块 中手动填入
q_proj,v_proj,k_proj,o_proj等,避免改动视觉编码器。
计算token
#在llamafactory目录中scripts/stat_utils/length_cdf.py
torchrun --nproc_per_node=1 scripts/stat_utils/length_cdf.py \
  --model_name_or_path 模型路径 \
  --dataset 文件名 \
  --dataset_dir path \
  --template 对话模板
例如
torchrun --nproc_per_node=1 scripts/stat_utils/length_cdf.py \
  --model_name_or_path /root/autodl-tmp/Qwen/Qwen2.5-7B-Instruct \
  --dataset hanjie \
  --dataset_dir /root/autodl-tmp/LLaMA-Factory/datasets/hanjie \
  --template qwen
外网访问llamafactory(在autodl平台上)
要使用公有连接要autodl-tmp/LLaMA-Factory/src/llamafactory/webui/interface.py文件下最后改成share=True
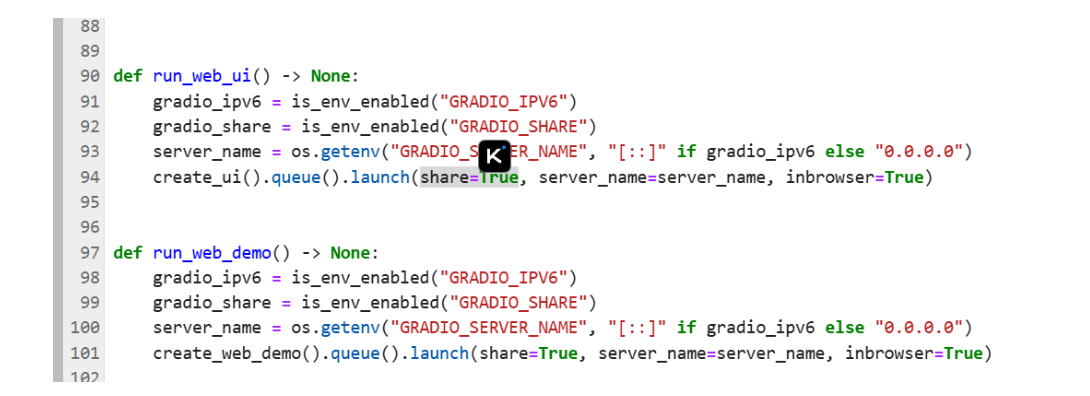
使用webui前开启学术加速,好像因为它会下载一个包,我也忘记了,不开代理可能会下载失败
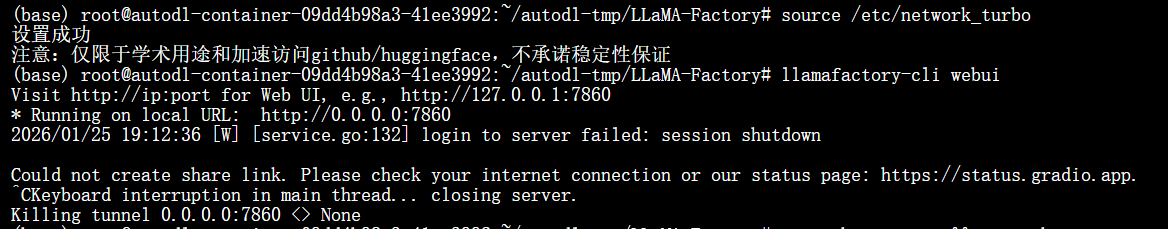
source /etc/network_turbo
llamafactory-cli webui
然后在
unset http_proxy && unset https_proxy
llamafactory-cli webui
如果不unset http_proxy && unset https_proxy会出现
GitHub链接:https://github.com/InternLM/xtuner
GitHub链接:https://github.com/axolotl-ai-cloud/axolotl
GitHub链接:https://github.com/deepspeedai/DeepSpeed
GitHub链接:https://github.com/unslothai/unsloth?spm=a2c6h.12873639.article-detail.4.19413e9fDtDunu